LeCun AI világa
(2026 szeptember)
Evolúciós "józan ész": Ha eltekintünk a technológiai céltudatosságtól, a jövőtervezéstől, akkor a tiszta biológiai létezés, az alkalmazkodás és a mentális jólét szintjén az állatok minden objektív mutatóban jobbak és sikeresebbek az embernél. Ha az embert megfosztjuk a technológiájától, egy meglehetősen védtelen, a környezetéhez rosszul alkalmazkodó lényt kapunk.
Ha a sikerességet a technológia nélküli tiszta biológiai túlélés, a környezeti egyensúly és a mentális jólét szintjén mérjük, akkor az állatok rendelkeznek a biológiai és ökológiai értelemben vett „józan ésszel”, amelyet evolúciós és adaptív intelligenciának nevezhetünk.
Míg az emberi „józan ész” (common sense) a kulturális és társadalmi normákhoz, továbbá az absztrakt dolgokhoz és a természeti jelenségekhez való igazodást is jelenti, az állatok világa a tiszta racionalitás mentén működik. Az állatok „józan esze” a természet törvényeinek való teljes, ellentmondást nem tűrő és sallangmentes engedelmesség. Az állati működés „józan ész” értelem, hogy pontosan annyi erőforrást fogyasztanak, amennyi a túléléshez és a szaporodáshoz, a populációs egyensúly fenntartásához szükséges: Ha lehet a populációs egyensúlyt borítva, elszaporodnak. Az állat önmagában, a saját biológiai valójában egy folyamatosan alkalmazkodó működőképes egész. Az ember a hiányosságait technológiával pótolta.
Az emberi józan ész: gyakorlatias, mindennapi túlélési és alapvető logikai készség, közhiedelmeken, hagyományokon alapul. A szokásjog és a józan ész (természetes ész) kapcsolata történelmi, a szokásjog a közösség által hosszú időn át tesztelt és bevált „józan ész” íratlan szabálygyűjteménye. A mindennapi élet valós problémáira adott gyakorlati válaszokból alakultak ki generációkon keresztül, a közösség tagjai szerint logikus, igazságos és megfelel a természetes értékrendnek. Ha a modern, írott törvényekben rés (joghézag) van, a bírák ma is a szokásjoghoz vagy a „józan ész szabályaihoz” nyúlnak vissza, azt vizsgálják, hogy az adott kultúrában mi számít elvárható, logikus és tisztességes értékrend szerinti viselkedésnek.
Mit kellene tanítani az AI-nak, hogy legyen "józan esze"?
A mai AI-nak nem tényeket, hanem a valóság mögöttes szerkezetét kell megtanítani (Gemini):
- Naiv Fizika és Világszimuláció (Intuitive Physics) tanítása. A mai AI-k szövegeket olvasnak, de nem „látják” az akció-reakció, a "ha-akkor" folyamatokat. Egy AI-nak olyan fizikai szimulációs motorokat (mint a videojátékok mögött futó szoftverek) kellene a „fejébe” építeni, amelyekkel a szöveges feladatokat le tudja futtatni.
- Ha az AI kap egy kérdést, a generálás előtt a belső szimulátorában „lejátszaná” a fizikai forgatókönyvet, és a válaszát nem a szavak valószínűségére, hanem a belső vizuális/fizikai szimuláció eredményére alapozná.
- Kauzális (Ok-Okozati) gráfok és nem-monoton logika. A mai AI statisztikai korrelációkat ismer fel (ha sokszor szerepel a „tűz” és a „füst” egy mondatban, összeköti őket). A józan észhez oksági viszonyokat kell tanítani. Meg kell tanítani a gépnek a „Mi lett volna, ha...?” (counterfactual) kérdések megválaszolását. A nem-monoton logika: a klasszikus AI-szabályok merevek (szillogozmusok, pl. „A madarak repülnek. A pingvin madár → a pingvin repül”). A józan ész alapja a rugalmasság: az AI-nak meg kell tanítani a kivételek és a kontextus kezelését is anélkül, hogy összeomlana a logikai rendszere.
- Az emberi „mentális forgatókönyvek” (Scripts) betáplálása. Az emberi józan ész nagy része olyan implicit (ki nem mondott) tudás, amit soha nem írunk le az interneten, mert nyilvánvaló. Az úgynevezett Common Sense Knowledge Base-eket (mint amilyen az MIT ConceptNet vagy az AI2 ATLAS projektje). melyek olyan óriási hálózatok, amelyek az élet apró, összefüggéseit rögzítik.
- Ha az AI-t arra kényszerítjük, hogy minden válaszadás előtt konzultáljon Common Sense Knowledge Base alapigazságokkal, elkerülhetőek a banális hibák, ha a Knowledge Base teljes.
- „Gondolatlánc” (Chain-of-Thought with Verifiers) A mai AI azonnal kimondja a következő szót, nincs „belső monológja”. A józan ész megköveteli, hogy az ember (az állat is) a cselekvés előtt gondolatban kitalálja, modellezze a a jövőt, jósoljon. Arra kell tanítani az algoritmust, hogy mielőtt válaszolna, generáljon több lehetséges gondolati jóslatot (fa-alapú keresés), majd futtasson le egy belső „Kritikus/Ellenőrző” modult (Verifier), ami kiszűri a fizikailag vagy logikailag képtelen verziókat.
- A tárgyakat nem szavakkal, hanem tulajdonság-vektorokkal kéne leírni: Súly, Keménység, Üregesség, Stabilitás. Ha az AI tudja, hogy egy „könyv” = [nehéz, lapos, szilárd], míg egy „selyemsál” = [könnyű, puha, hajlékony], akkor test nélkül is képes lesz kikövetkeztetni, hogy a könyv alkalmasabb egy ajtó kitámasztására.
- Összegezve: Hogyan nézne ki a "Józan ész AI"? Nem óriási nyelvi modellt kellene építeni, hanem egy hibrid rendszert (Szimbolikus AI) Egy értelmező szótár (Explanatory dictionary, egy LLM) megérti a felhasználó kérdését és átadja a feladatot egy belső fizikai/valószínűségi-kauzális szimulátornak. A szimulátor ellenőrzi a valósághűséget a "Józan ész adatbázis"-ban. A gép csak ezután fordítja vissza az eredményt emberi nyelvre.
Affordancia-elmélet (A környezet lehetőségeinek látása): Nem szavak definícióit kell megtanítani, hanem azt, hogy a tárgyak mire használhatóak a fizikai történésekben. Az AI-nak a tárgyak funkcionális kapcsolatát kéne megtanulnia (Explanatory dictionary). Megerősítéses tanulás fizikai büntetéssel/jutalommal (Pain and Reward): nem emberek által előre megírt szabályokat (pl. "ha piros a lámpa, állj meg") kell beléplántálni, hanem a természeti törvények megtapasztalását. A tanulási algoritmusának alapját a fizikai épség megőrzése (jutalom) és a sérülés/energiapazarlás (fájdalom/büntetés) kellene, hogy képezze.
Költség-haszon alapú döntéshozatali reflexek: Meg kell tanítani az AI-nak a „nem-cselekvés” értékét, következményeit. A mai AI mindig válaszol, mindig generál, mindig számol. Meg kell tanulnia a pihenés és a készenléti állapot racionalitását: ha egy feladat elvégzése több energiát igényel, mint amennyi hasznot (energiát/biztonságot) hoz, akkor a racionális döntés a passzivitás. A „nem-cselekvés” kárt is okozhat pl. a fizikai épségben, kikényszerítheti a feledat megoldását.
A „Generatív” AI-tól az „Evolúciós” AI-ig: a mai nagy nyelvi modellek (LLM-ek) az emberi kultúra absztrakt felépítményét (a nyelvet) utánozzák, de átugrották az evolúciós szakaszt, az első 3,5 milliárd évét. Az állati-emberi józan ész eléréséhez nem több internetes szövegre van szükség, hanem szabályokra. A ChatGPT-szerű nagy nyelvi modellek (LLM-ek) azért buknak el a varjak vagy kutyák számára triviális feladatokon, mert a működésük statisztikai valószínűségszámításon, és nem a valóság modelljén alapul. Az AI a szavak egymás utáni következésének mintázatait ismeri, míg az állat a fizikai világ ok-okozati törvényeit. A legfőbb okok és konkrét példák, ahol a szövegalapú AI elbukik az állati „józan ésszel” szemben:
1. Az ok-okozati összefüggések (Kauzális logika) hiánya. Egy új-kaledón varjú képes megoldani az „Aesopus-tesztet”: ha egy úszó jutalomfalat túl mélyen van egy vizespohárban, nehéz kavicsokat dobál bele, hogy a vízszint megemelkedjen. Érti a kiszorítási törvényt, és ha lyukas vagy könnyű (pl. parafa) tárgyat adnak neki, azt az első próbálkozás után eldobja, mert nem hoz eredményt. Mivel a tréningadatokban nem szerepel pontosan ez a helyzet, az AI nem „látja” a tárgyak tömegét, tapadását vagy rugalmasságát, csak nyelvtanilag helyes, de fizikailag működésképtelen instrukciókat generál.
2. A „Fizikai Állandóság” (Object Permanence) hiánya Egy kutya pontosan tudja, hogy ha a gazdája elgurít egy labdát a kanapé mögé, a labda nem szűnt meg létezni, sőt, a labda röppályája alapján azt is kiszámítja, hogy a kanapé melyik oldalán fog kibukkanni. Miért bukik el az AI? Az LLM-eknek nincs állandó belső 3D-s térképük a világról. Egy klasszikus tesztben a kutatók ezt kérdezik az AI-tól:„Egy asztalon van egy pohár. Beteszek alá egy golyót. Megfogom a poharat, átviszem a konyhába, és leteszem a hűtő tetejére. Hol van a golyó?” A hiba: Az AI gyakran azt válaszolja, hogy a golyó a hűtő tetején van. Nem számolja ki a fizikai következményt: ha a poharat felemelem és elviszem, a golyó az asztalon marad, mert nincs rögzítve. Az AI a szavak szintjén „összeköti” a poharat és a golyót, de nem modellezi a gravitációt és a fizikai határokat.
3. Az „Affordancia” (Mire jó egy tárgy? Ld: az értelmező szótárt, Explanatory dictionary) teljes hiánya Az állatok a tárgyakat nem a nevük, hanem a bennük rejlő funkcionális lehetőségek (affordanciák) alapján nézik. Egy kutya számára egy fejre fordított műanyag vödör egy lépcsőfok, amire ráállva eléri a pultot. Egy varjú számára egy drótdarab nem „fémötvözet”, hanem egy kampóvá hajlítható célszerszám.
A "józan ész" alapú ügynökök (MCS-agent) lényege, hogy olyan bonyolult problémákra adnak gyors és egyszerű, kis hardver igényű választ, amikor a tökéletes (optimális) megoldás kiszámítása túlságosan időigényes vagy technikai okokból nehéz. A természetes gondolkozás (józan paraszti ész, mérése NQ): a megállapítások azért egyeznek, mert közel azonos alapokról valaki ugyanarra a következtetésekre jut, amennyiben a gondolkozása természetes. Az "egyszerűség elve": két, az adott jelenséget egyformán jól leíró magyarázat közül az egyszerűbbet érdemes választani, ami egyben a Bayes döntés a matematikában, az is hasonlóan választ. (Latinul „lex parsimoniae”, azaz a „tömörség elve”, azaz „Csak szükség esetén feltételezzük a sokféleséget”, https://en.wikipedia.org/wiki/Occam%27s_razor.) A józan ész válaszai a "Miért?" kérdésekre nem tudományos elemzések, hanem tapasztalatokon, megfigyeléseken alapuló reakciók, pl. az időjárással kapcsolatos megfigyelések, de általában egybe esnek a tudományos érveléssel.
A világmodell alapjait (naiv fizika, ok-okozati összefüggések) LeCun szerint videókon és szenzoros adatokon keresztül kell betanítani, önfelügyelt tanulással, maszkolással, és nem szövegeken keresztül. A V-JEPA rendszere ötvözi a világmodelleket a szöveges predikcióval. LeCun a világmodellt egy olyan "szimulátorként" képzeli el, amely a fizikai jelenségeket modellezi, a rendszer a fizikai tudását nem a nyelvi modellekből, hanem közvetlenül video megfigyelésekből nyeri.
A LeCun féle V-JEPA modellek tanítása videók segítségével a fizikai törvények felismerésére: a V-JEPA (Video Joint Embedding Predictive Architecture) modell a világ fizikai működését igen nagy videóállományok tanulásával (self-supervised learning), maszkolással sajátítja el. A folyamat lényege, hogy a gép magyarázatokat nem kap. Maszkolási stratégia (Masking): a modellnek videórészleteket mutatnak, de a képkockák egy részét (térben és időben) kitakarják. A rendszer feladata, hogy kitalálja, mi van a "maszk" alatt. A maszkolatlan adat alapján is jósol, és a felfedett adat összehasonlításával kapja az előrejelzési hibát.
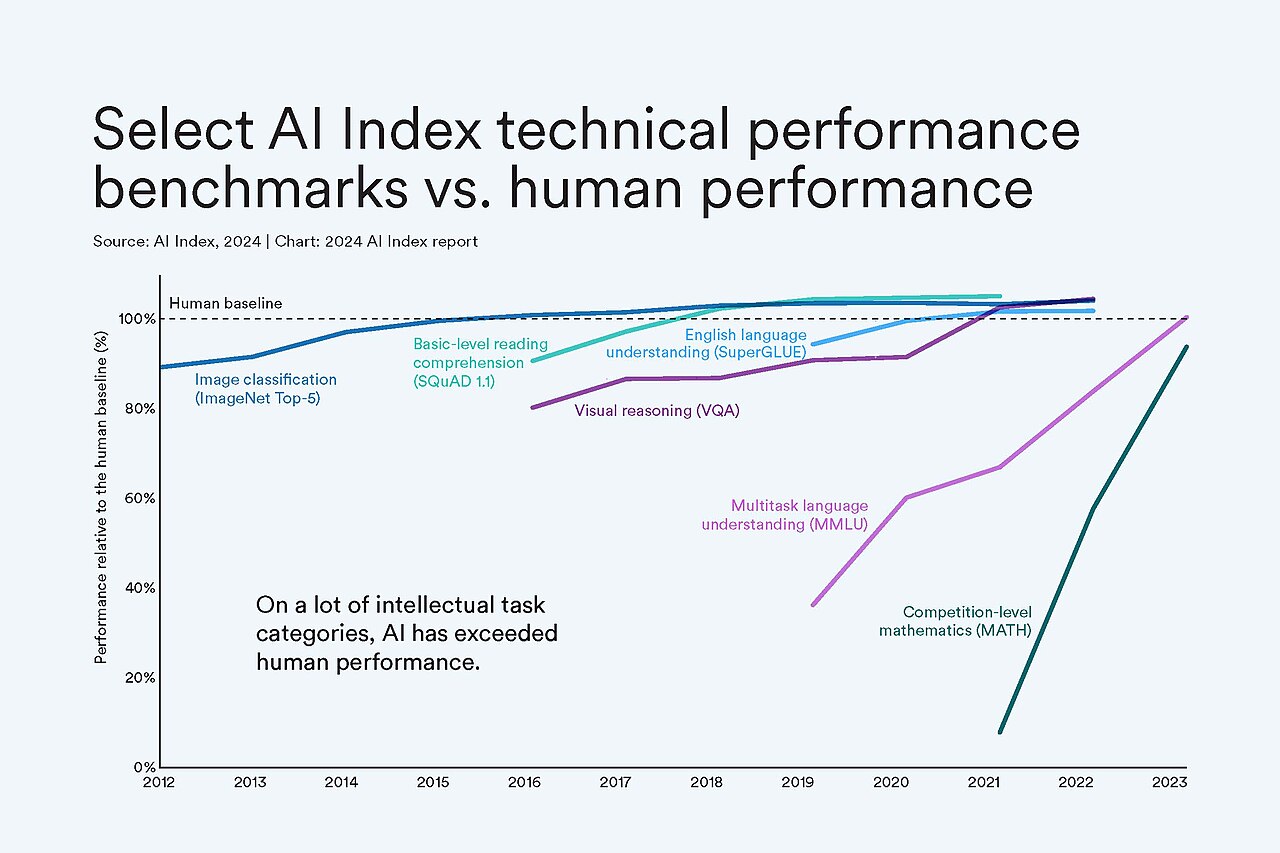
Az AI a szavakat absztrakt fogalomhálókban tárolja: egy Explanatory dictionary leképzése kifeszít egy latens teret, és nem funkcióként. A reprezentációs, látens térben (állapottér, latent space) jósolja meg a tárgyak tulajdonságait és mozgását, ami azért fontos, mert a valóság kiszámíthatatlan részleteit figyelmen kívül hagyhatja, és a lényegre (pl. a pohár esése) koncentrál. A tanítás során a modell folyamatosan összeveti a jóslatait a tényleges videókkal. Ha a jóslat hibás (pl. egy elguruló labda a jóslattal ellentétben nem tűnik el a fal mögött, hanem átmegy rajta, azaz a "labda megmaradásának elve"), ellentmondásra jut. Az előrejelzés hibája javítja a világmodell működését, megerősítéssel a helyes válaszoknál. Több ezer órányi videó (pl. YouTube-klipek) megfigyelése után a modell felismeri az objektum állandóságát (tudja, hogy ami kimegy a képből, az még létezik) és a tárgyak dinamikáját. A világmodell egy MIT ConceptNet változat a latens térben. A kutatások szerint a JEPA képes 98%-os pontossággal felismerni, ha egy videóban fizikai törvény teljesül vagy nem teljesül, miközben a hagyományos LLM-ek ezen a téren sokszor csak tippelnek.
LeCun JEPA-modell azt tanulja meg a látens térben, hogy ha a V1 vektor (állapot) és a VA vektor (akció) találkozik, az törvényszerűen a V2 vektorhoz vezet, biztonságosan modellezi az ok-okozati összefüggéseket. Úgy működik, mint egy videójátékos, aki nem tudja megfogalmazni a fizikai egyenleteket vagy a játékmotor kódját, de a belső vektortere miatt 100%-os pontossággal tudja, mi fog történni a következő pillanatban.
Számábrázolási probléma: a tér folytonos kitöltése helyett egy durvább, diszkrét geometriai rácsot (hasonlóan a Vector Quantized / VQ-VAE modellekhez, de nem pixel szinten) célszerű használni, ekkor a vektorok (gráfok) nem vehetnek fel bármilyen értéket, csak bizonyos "csomópontok" értékeit. A csomópontok összessége a diszkrét latens tér, ami olcsóbb, mert a hálózatnak nem kell folytonos számok végtelen halmazában navigálnia, a rácspontok pedig közvetlenül lefordíthatóak logikai Vi állapotokká, (i = 1,2,3,..., ami milliárdos érték is lehet az állapottérben). Sparse Coding: LeCun egyik legnagyobb kihívása, hogy a latens tér ne omoljon össze egyetlen konstans-ponttá. A szótáralapú korlátozás és a ritkasági kényszer (regularizáció) természetes módon megakadályozza ezt az összeomlást.
Talán egy videójátékmotor (pl. Unreal Engine) szabályrendszerével egy jobb asztali számítógép is képes lenne megjeleníteni a LeCun modellt, mert a következtetés, predikció számításigénye a diszkrét térben lecsökkent. A rácsfelbontás rugalmasan is választható.
Ha a diszkrét látens tér és a játékalgoritmusok motorjai között sikerülne találni egy-egy értelmű leképzést, azaz az AI képes lenne a LeCun-féle embedding-eken keresztül megérteni a videójátékok kódolt szabályrendszereit (oka-okozati összefüggéseket), "értené" a szabályokat, és a diszkrét látens tér történéseinek, és a következtetéseinek megjelenítése egyszerűvé válna (a játékalgoritmus leképzése a diszkrét latens térbe, és az inverze pedig az Explanatory dictionary latens térbeli alakjából ismert.). Hatékonyabb tanulás: ahelyett, hogy egy AI-nak milliónyi videót kellene megnéznie ahhoz, hogy megértse a gravitációt. A játékalgoritmusok absztrakt matematikai struktúráit "beágyazva" (embedding formájában) elsajátítaná a világ működésének logikáját. Egy Józan AI-ügynök nemcsak chatelni tudna, hanem képes lenne terveket alkotni, logikusan gondolkodni, és autonóm módon cselekedni a fizikai vagy digitális térben is.
A 98%-os hiba

Működése:
• Kutatói/Fejlesztői fázis: LeCun előrejelzései szerint a jelenlegi generatív LLM AI modellek 3-5 éven belül elérik a korlátaikat. A 2029–2031 közötti időszakban az első funkcionális világmodellek laboratóriumi környezetből kilépve, futtathatóvá és tesztelhetővé válhatnak, a Metánál már fut egy változat.
• Gyakorlati/Ipari áttörés (2030-as évek): LeCun jóslata szerint a fizikai világot érzékelő, kauzális logikát, józan észen alalpuló autonóm rendszerek és a fejlett robotika fúziója a 2030-as évekre érik be. és várható a modellek széles körű ipari alkalmazása (pl. önvezetés, gyártás, egészségügy).
A Meta FAIR laboratóriumában végzett alapozó kutatások (például a videópredikciós tanulási modellek, mint a V-JEPA) részben nyilvánosak, a nyílt forráskódú közösség folyamatosan implementálja LeCun elméleti koncepcióit (pl. egyszerűsített világmodell-architektúrákat), amelyek kísérleti jelleggel, fejlesztői környezetben már most is tesztelhetőek. Yann LeCun a Világmodell (World Model) koncepcióját és a kapcsolódó JEPA-architektúrát eredetileg a Metánál (illetve a FAIR kutatólaborban) fejlesztette ki, majd elhagyta a Metát.
• Fejlesztés a Metánál (2022–2025): LeCun a Meta vezető AI-kutatójaként (Chief AI Scientist) 2022-ben mutatta be a Joint Embedding Predictive Architecture (JEPA) elméleti alapjait. A Meta keretein belül olyan nyílt forráskódú világmodelleket építettek és adtak ki, mint az I-JEPA (képekre) és a V-JEPA 2 (videókra és fizikai szimulációkra).
• Kiválás a Metából (2025 vége): 2025 novemberében LeCun bejelentette távozását a Metától. Ennek hátterében az állt, hogy a Meta AI-stratégiája egyre inkább a nagy nyelvi modellekre (LLM, pl. Llama) és a gyors termékesítésre fókuszált, míg LeCun az LLM-eket zsákutcának tartja az emberi szintű intelligencia eléréséhez.
• Saját cég alapítása (2026): LeCun megalapította az AMI Labs (Advanced Machine Intelligence) nevű startupot Párizsban. A cég 2026 tavaszán mintegy 1 milliárd dolláros tőkebevonással indult el (olyan befektetőkkel, mint az Nvidia és Jeff Bezos), hogy a fizikai valóságot és az ok-okozati összefüggéseket megértő világmodelleket fejlesszen robotikai és egyéb alkalmazásokhoz.
Bár LeCun már nem a Meta alkalmazottja, új cége, az AMI Labs szoros kutatási együttműködést tart fenn a Metával. Yann LeCun cége, az AMI Labs az első naptól kezdve globálisan működik. Bár a vállalat központja Párizsban van, a kutatás és a fejlesztés négy kulcsfontosságú nemzetközi csomóponton zajlik egyszerre:
• New York (Maga Yann LeCun is elsősorban itt él és dolgozik, a New York-i Egyetem professzoraként és a startup elnökeként)
• Montréal (A világ egyik legfontosabb deep learning és AI-kutatási fellegvára)
• Szingapúr (Az ázsiai tech- és kutatói jelenlét biztosítására)
Az iroda vezetéséért Alexandre LeBrun (CEO) felel, a kutatási irányokat pedig Saining Xie (Chief Science Officer), a vizuális reprezentációk és a diffúziós architektúrák (pl. DiT) szakértője, valamint Michael Rabbat (VP of World Models) irányítja közvetlenül.