A nyílt és zárt paraméterű modellek telepítése, üzemeltetése Európában
(2026 novembember 21.)
A mai helyzet
Donald Trump amerikai elnök megtiltotta (Nov. 20,) az amerikai vállalatoknak, hogy külföldön mesterséges intelligencia alapú adatközpontokat építsenek, különben „óriási adóval” nézhetnek szembe. A technológiai óriások, mint például a Meta és a Google kötöttek megállapodásokat adatközpontok külföldi építéséről, így nem világos, hogyan lehet érvényesíteni a szabályozást. „Nem fogjuk megengedni a vállalatainknak, hogy adatközpontokat építsenek az országunkon kívül, Európában. Mert Kína mindannyiukat el fogja vinni, és mi nem engedjük, hogy ez megtörténjen”, mondta Trump: az USA nem engedi, hogy Kína megelőzze az Egyesült Államokat az AI terén: https://www.bbc.com/news/articles/cmde1lw9y54ko. De az európai vállalatok és kormányok már ma is olcsó nyílt kínai technológiát, és a kínai nyílt modelleket választják saját infrastruktúrájukhoz. Továbbá a gallium és a germánium szerepe stratégiai jelentőségű, az előbbi egyes nagy teljesítményű chipekben, utóbbi többek között optikai szálakban és infravörös érzékelőkben kap helyet. Felhasználási területeiken helyettesítésük komoly technológiai nehézségekbe ütközik, ellátásuk 99%-ban Kínától függ: Kina az AI-számítástechnikában már Európában van.
A Pew Research Centre adatai szerint áprilisban körülbelül 3000 adatközpont működött az Egyesült Államokban, további 1500 pedig az engedélyezés és az építés különböző szakaszaiban volt. (A Gemini AI-t használtuk netes keresésre.) Az olyan problémákkal kapcsolatos aggodalmak, mint a zajszennyezés és az energiafogyasztás, hozzájárultak ahhoz, hogy a demokrata jelöltek november 3-án győzelmet arattak az adatközpontok építésére vonatkozó szigorúbb szabályokra vonatkozó ígéretükkel, ezért is történik a külföldi építés. (BBC) Az USA-ban a piaci szereplők már megkérdőjelezik, hogy a mesterséges intelligencia infrastruktúrájára, a chipekre és a számítási kapacitásra fordított óriási összegek mikor térülnek meg? (Esik a Nasdaq.)
A kínai cégek Kínában és Európában fejlesztik a nyílt súlyozású (open-weight) modelljeiket, az európai fejlesztés (tanítás), a helyi futtatás és telepítés már intenzíven történik.
1. Tanítás és építés Európában (amerikai chipeken): egy hardveres kiskapu kihasználása. Mivel az Egyesült Államok korlátozza a csúcskategóriás Nvidia AI-chipek közvetlen exportját Kínába, több kínai AI-labor (például a DeepSeek, a Kimi modelleket jegyző Moonshot AI) európai adatközpontokban bérel számítási kapacitást, hogy ott tanítsa be és fejlessze tovább a modelljeit. Válaszul Washington és az Nvidia 2026 végén szigorításokat vezetett be, így a külföldi adatközpontokban is korlátozzák (például maximum 49%-ban maximalizálják) a kínai vállalatok által használható kapacitást.
2. Ezért saját kínai felhőket, szervereket épít Kína Európában
Adatvédelmi megfelelés (GDPR): az európai cégek adatbiztonsági okokból nem küldhetnek adatokat kínai szerverekre. Ennek áthidalására az Alibaba Cloud új adatközpontokat és felhőrégiókat nyitott Európában (például Párizsban, Amszterdamban, Finnországban, valamint Németországban és az Egyesült Királyságban), hogy a Qwen modelleket helyben, európai adatokkal futtassa az ügyfeleknek.
• Helyi kihelyezés (On-premise): a Tencent Cloud Europe kifejezetten abban segít európai távközlési és pénzügyi cégeknek, hogy nyílt modelleket (például a kínai DeepSeeket) saját, zárt szerverparkjukon futtassanak.
• Helyi kihelyezés (On-premise): a Tencent Cloud Europe kifejezetten abban segít európai távközlési és pénzügyi cégeknek, hogy nyílt modelleket (például a kínai DeepSeeket) saját, zárt szerverparkjukon futtassanak.
3. Európai cégek futtatják a kínai modelleket
• Európai szuverén felhők: mivel a modellek nyílt súlyozásúak (bárki letöltheti őket), sok európai infrastruktúra-szolgáltató (például a német/északi régiós Lyceum vagy az Amazon Bedrock európai régiói) saját, Európában található Nvidia szerverein futtatja a DeepSeek, Qwen és GLM modelleket.
• Tömeges európai elterjedés: a fejlesztői platformokon (például az OpenRouteren) az EU-s tokenforgalom több mint felét már a kínai modellek teszik ki, mivel olcsóbbak az amerikai zárt modelleknél, és helyben futtatva nem küldenek adatot Kínába.
• Tömeges európai elterjedés: a fejlesztői platformokon (például az OpenRouteren) az EU-s tokenforgalom több mint felét már a kínai modellek teszik ki, mivel olcsóbbak az amerikai zárt modelleknél, és helyben futtatva nem küldenek adatot Kínába.
Bár a nyílt forráskódú modellek (például a DeepSeek vagy a Qwen) súlyai szabadon letölthetőek, a betanításukhoz és a nagy léptékű futtatásukhoz nagy szerverparkokra és csúcskategóriás amerikai chipekre (pl. Nvidia) van szükség. A kínai cégek külföldi (például európai, délkelet-ázsiai) adatközpontokból bérelnek számítási kapacitást az amerikai exportkorlátozások megkerülésére. Ha az amerikai techóriások (mint a Google vagy a Meta) külföldön építenek adatközpontokat, az ottani infrastruktúrát és kapacitást könnyebben elérhetik vagy kibérelhetik harmadik feleken keresztül a kínai fejlesztők. A belföldi építés kényszerítésével az amerikai kormányzat közvetlenebb felügyeletet gyakorolhat a hardverek felett. A nyílt kínai modellek olcsóságukkal és hozzáférhetőségükkel gyorsan és globálisan terjednek. Trump stratégiája az, hogy az összes csúcstechnológiás infrastruktúrát az USA-ban koncentrálja, így az amerikai cégek (például az OpenAI vagy az Anthropic) maradnak a leggyorsabb számítási kapacitás birtokában, amivel a zárt, csúcskategóriás rendszerek fejlesztésében megőrizhetik a fölényüket. Szakértők szerint a tiltás vissza is üthet. Ha az amerikai cégek nem építhetnek adatközpontokat külföldön (például Európában vagy Ázsiában), az európai vállalatok és kormányok a kínai technológiát és a kínai nyílt modelleket választják saját infrastruktúrájukhoz.
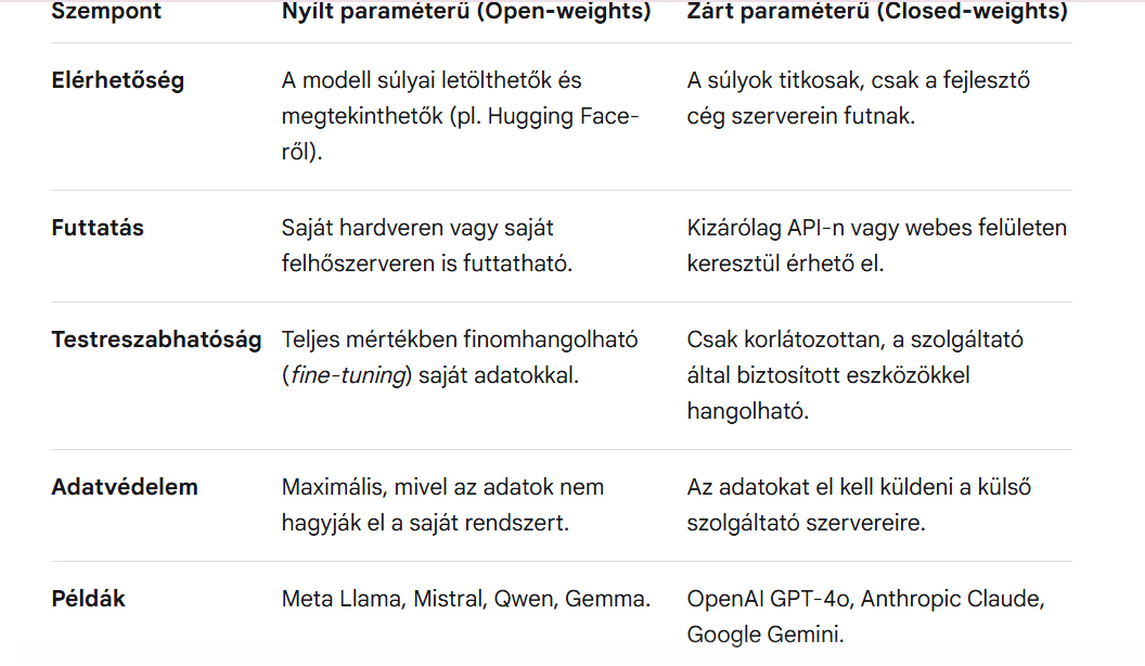
1. Mesterséges intelligencia: LLM – Nagy nyelvi modellek, nem nyilvános súlyokkal, vagy Nyílt paraméterű modellek
Az AI-modellek esetében a "paraméterek" (súlyok) azok a belső számértékek, amelyeket a modell a tanítás során megtanult, amelyek meghatározzák a viselkedését.
| Szempont | Nyílt paraméterű (Open-weights) | Zárt paraméterű (Closed-weights) |
|---|---|---|
| Elérhetőség | A modell súlyai letölthetőek és megtekinthetőek (pl. a Hugging Face-ről). | A súlyok titkosak, csak a fejlesztő cég szerverein futnak. |
| Futtatás | Saját hardveren vagy saját felhőszerveren is futtatható. | Kizárólag API-n vagy webes felületen keresztül érhető el. |
| Testreszabhatóság | Teljes mértékben finomhangolható saját adatokkal. | Csak korlátozottan, a szolgáltató által biztosított eszközökkel hangolható. |
| Adatvédelem | Maximális, mivel az adatok nem hagyják el a saját rendszert (pl. Coios-védelem) | Az adatokat el kell küldeni a külső szolgáltató szervereire. |
| Példák | Meta Llama, Mistral, Qwen, Gemma, Deep Seek. | OpenAI GPT-4o, Anthropic Claude, Google Gemini. |
(Megjegyzés: A "nyílt paraméterű" nem mindig jelent teljesen "nyílt forráskódút", mert a tanítóadatok és a tanító kód sokszor rejtve maradnak, csak maga a modell tölthető le.)
2. Programozás és API-tervezés
Szoftverfejlesztésben paraméterek az API-végpontok bemeneti értékei is. Az API (Application Programming Interface, azaz alkalmazás illesztő felület) lehetővé teszi két különböző program számára, -az AI és a végfelhasználó- hogy paraméterátadással kommunikáljanak egymással.
A fejlesztőknek beépíthetnek kész funkciókat, például térképeket, időjárás-jelentést vagy online fizetési rendszereket, a saját AI programjukba. Az API szabályozott keretek között működik, így a rendszerek csak azokat az adatokat osztják meg egymással, amelyekre valóban szükség van. Zárt paraméteres esetben a függvény vagy végpont csak előre pontosan meghatározott nevű és típusú bemeneteket fogad el, minden más adatot hibaüzenettel elutasít, ami biztonságosabb és könnyebben ellenőrizhető. Nyílt és bővíthető paraméteres esetben arendszer megengedi tetszőleges, előre nem definiált kulcs-érték párok vagy extra adatok átadását is
A fejlesztőknek beépíthetnek kész funkciókat, például térképeket, időjárás-jelentést vagy online fizetési rendszereket, a saját AI programjukba. Az API szabályozott keretek között működik, így a rendszerek csak azokat az adatokat osztják meg egymással, amelyekre valóban szükség van. Zárt paraméteres esetben a függvény vagy végpont csak előre pontosan meghatározott nevű és típusú bemeneteket fogad el, minden más adatot hibaüzenettel elutasít, ami biztonságosabb és könnyebben ellenőrizhető. Nyílt és bővíthető paraméteres esetben arendszer megengedi tetszőleges, előre nem definiált kulcs-érték párok vagy extra adatok átadását is
3. Milyen a tipikus AI-integrátori rendszerszervezés?
Ha egy IT-cég vagy rendszergazda-csapat AI-integrátorrá akar válni, a klasszikus rendszergazdai feladatok mellé be kell emelnie két másik területet is:
1. Üzleti tanácsadás, folyamatfelmérés. szervezés: megvizsgálják, hol folyik el a legtöbb idő a cégnél (pl. ajánlatírás, ügyfélszolgálat, szerződésellenőrzés), ami AI-vel megsegíthető,
2. Szoftverfejlesztés és adatkezelés (AI Engineering): megírják azokat az összekötő, illesztő kódokat (API-kat), amelyekkel a nyílt paraméteres modell hozzáfér a cég belső adatbázisaihoz, és beállítják, hogy ne hallucináljon.
3. Rendszergazdai üzemeltetés* létezik ma is: a rendszergazda üzemelteti a szervert (vagy a privát felhőt), gondoskodik a tűzfalról, a jogosultságokról és a folyamatos működésről. Egy jó rendszergazdának van a legjobb esélye arra, hogy sikeres AI-integrátorrá váljon, mert már megvan a bizalom az ügyfeleknél, és ért a szerverekhez, amihez az AI-specifikus szoftveres és adatkezelési tudást kell hozzátennie: az API drága program, és a forgalmát is tokenenként (4 betűs egységek) megfizettetik. Az API-t kell megszereznie, üzemeltetnie és "eladnia", jó üzlet.
1. Üzleti tanácsadás, folyamatfelmérés. szervezés: megvizsgálják, hol folyik el a legtöbb idő a cégnél (pl. ajánlatírás, ügyfélszolgálat, szerződésellenőrzés), ami AI-vel megsegíthető,
2. Szoftverfejlesztés és adatkezelés (AI Engineering): megírják azokat az összekötő, illesztő kódokat (API-kat), amelyekkel a nyílt paraméteres modell hozzáfér a cég belső adatbázisaihoz, és beállítják, hogy ne hallucináljon.
3. Rendszergazdai üzemeltetés* létezik ma is: a rendszergazda üzemelteti a szervert (vagy a privát felhőt), gondoskodik a tűzfalról, a jogosultságokról és a folyamatos működésről. Egy jó rendszergazdának van a legjobb esélye arra, hogy sikeres AI-integrátorrá váljon, mert már megvan a bizalom az ügyfeleknél, és ért a szerverekhez, amihez az AI-specifikus szoftveres és adatkezelési tudást kell hozzátennie: az API drága program, és a forgalmát is tokenenként (4 betűs egységek) megfizettetik. Az API-t kell megszereznie, üzemeltetnie és "eladnia", jó üzlet.
4. Nyilvános paraméterű és nyílt forráskódú (open-weight / open-source) modellek (az API árak problémája)
A nyílt forráskódú (open-weight / open-source) AI modellek értékesítéséből kisebb a közvetlen profit, mint a zárt modellekből, mert a modell ingyenesen letölthető és használható, így
• Nincs licencdíj: a fejlesztők nem tudnak tokenenkénti (API) vagy előfizetéses díjat kérni pusztán a modell kódjáért vagy súlyaiért, mert bárki letöltheti és futtathatja azt a saját szerverein.
• Árverseny: a nyílt modellek megjelenése lenyomja a piaci árakat, így a zárt modellek (pl. OpenAI, Anthropic) már nem tudnak magas árat szabni.
• Árverseny: a nyílt modellek megjelenése lenyomja a piaci árakat, így a zárt modellek (pl. OpenAI, Anthropic) már nem tudnak magas árat szabni.
• A nyílt modelleket fejlesztő cégek másként termelnek profitot:
Felhőinfrastruktúra esetén a modell ingyenes, de a futtatásához szükséges drága szerverkapacitást (GPU-kat) a cég bérbe adja. (Microsoft Azure, AWS, Google Cloud).
Rendszer védelem (Moat): bár a cég ingyenessé teszi az alaptechnológiát, hogy a versenytársak ne tudjanak monopóliumot építeni, így a saját fő üzletága (pl. hirdetések) biztonságban marad. (Meta, Llama modellek)
Prémium verziók esetén a kisebb, alapmodell nyílt és ingyenes, de a nagyobb tudású, vállalati verziók már fizetősek és zártak. (Mistral AI, Cohere)
Vállalati támogatás és testre szabásnál a nagyvállalatok fizetnek a biztonsági garanciákért, a finomhangolásért és a technikai támogatásért. (Red Hat, Hugging Face).
Prémium verziók esetén a kisebb, alapmodell nyílt és ingyenes, de a nagyobb tudású, vállalati verziók már fizetősek és zártak. (Mistral AI, Cohere)
Vállalati támogatás és testre szabásnál a nagyvállalatok fizetnek a biztonsági garanciákért, a finomhangolásért és a technikai támogatásért. (Red Hat, Hugging Face).
Tehát maga a nyílt modell nem is termel profitot, de köré fizetős szolgáltatásokat, hardvereladásokat vagy felhőalapú infrastruktúrát építenek. Mivel a fejlesztő cégek (mint a Meta a Llama-sorozattal, a Google a Gemmával, a Mistral vagy a kínai DeepSeek és Qwen) a komoly betanítási költségek után ingyen adják át a végeredményt, a profitjuk máshogy épül fel, mint a zárt modelleknél (mint a GPT vagy a Claude).
• Ingyenes „alapanyag”: Bárki letöltheti a paramétereket (pl. a Hugging Face-ről), és saját szerveren futtathatja, így a modell készítője egyetlen fillért sem lát a használatból.
• Árháború az API-piacon: Mivel a nyílt súlyokhoz bárki hozzáférhet (pl. Together AI, Fireworks, Groq), az API-hozzáférés ára a puszta villanyszámla és hardverköltség szintjére zuhan. Nincs szellemi tulajdonon alapuló felár.
A nyílt modelleket fejlesztő cégek nem a modellen, hanem a körülötte lévő szolgáltatásokon keresnek pénzt:
1. A „Commoditize Your Complement” (Tedd tömegcikké a kiegészítőt) stratégia:
A Meta például nem AI-előfizetésekből él, hanem hirdetésekből. Azzal, hogy ingyenessé tette a Llama paramétereit, megakadályozta, hogy az OpenAI vagy a Google monopolizálja az AI-piacot és megszabja az árakat. Söt a fejlesztők ingyen optimalizálják a Meta által használt technológiákat.
2. Hardver- és felhőeladások ösztönzése:
A Google (Gemma) vagy a Microsoft (Phi) azért ad ki nyílt paraméteres modelleket, hogy a fejlesztők az ő felhőszolgáltatásaikon (Google Cloud, Azure) béreljenek drága GPU-kat a modellek futtatásához és finomhangolásához.
Az Nvidia is számos nyílt modellt ad ki, mert minél többen futtatnak helyben AI-t, annál több videókártyát ad el.
3. Vállalati „Enterprise” csomagok és zárt csúcsmodellek:
A Mistral vagy a Cohere a kisebb, nyílt paraméteres modellekkel hírnevet és fejlesztői bázist épít, majd a nagyvállalatoknak már a zárt, nagyobb teljesítményű modelleket, illetve a biztonsági és jogi garanciákat adja el jó pénzért.
4. Költségcsökkentés (DeepSeek-modell):
Olyan cégek, mint a DeepSeek, hatékony architektúrát fejlesztettek ki, amellyel a betanítás és a futtatás is töredékébe kerül a versenytársakénak, így még a nyomott piaci API-árak mellett is képesek nyereségesek maradni.
A Meta például nem AI-előfizetésekből él, hanem hirdetésekből. Azzal, hogy ingyenessé tette a Llama paramétereit, megakadályozta, hogy az OpenAI vagy a Google monopolizálja az AI-piacot és megszabja az árakat. Söt a fejlesztők ingyen optimalizálják a Meta által használt technológiákat.
2. Hardver- és felhőeladások ösztönzése:
A Google (Gemma) vagy a Microsoft (Phi) azért ad ki nyílt paraméteres modelleket, hogy a fejlesztők az ő felhőszolgáltatásaikon (Google Cloud, Azure) béreljenek drága GPU-kat a modellek futtatásához és finomhangolásához.
Az Nvidia is számos nyílt modellt ad ki, mert minél többen futtatnak helyben AI-t, annál több videókártyát ad el.
3. Vállalati „Enterprise” csomagok és zárt csúcsmodellek:
A Mistral vagy a Cohere a kisebb, nyílt paraméteres modellekkel hírnevet és fejlesztői bázist épít, majd a nagyvállalatoknak már a zárt, nagyobb teljesítményű modelleket, illetve a biztonsági és jogi garanciákat adja el jó pénzért.
4. Költségcsökkentés (DeepSeek-modell):
Olyan cégek, mint a DeepSeek, hatékony architektúrát fejlesztettek ki, amellyel a betanítás és a futtatás is töredékébe kerül a versenytársakénak, így még a nyomott piaci API-árak mellett is képesek nyereségesek maradni.
Összefoglalva: A nyílt paraméteres modelleken önmagukban nincs közvetlen profit, sőt hatalmas kezdeti veszteséget (több tíz- vagy százmillió dolláros betanítási költséget) jelentenek. A haszon a hardvereladásokból, a felhőszolgáltatásokból, a piaci pozíció védelméből és a fizetős vállalati szolgáltatásokból folyik be.
Európai nyílt paraméteres modellek üzemeltetése
A magyar és európai cégek a szigorú adatvédelmi szabályozásoknak (GDPR, EU AI Act) való megfelelésben, a kiszámítható üzemeltetési költségekben és a saját szakterületre szabott hatékonyságban tudnak üzleti előnyt kovácsolni a nyílt paraméteres (open-weights) modellekből. Míg a tech óriások a modellek fejlesztésével csinálnak profitot, az európai vállalkozások (legyen szó szoftverfejlesztő cégekről, bankokról vagy e-kereskedőkről) felhasználóként és integrátorként nyerhetnek rajtuk a legtöbbet.
1. Adat szuverenitás és GDPR / EU AI Act megfelelőség
Az európai piacon nagy akadály az amerikai zárt modellek (pl. OpenAI, Anthropic) használatánál az adatbiztonság.
• Helyi vagy EU-s szerveren történő futtatás: ha egy cég saját szerveren (vagy európai adatközpontban) futtat egy nyílt paraméteres modellt (pl. Llama, Mistral, Qwen), az ügyféladatok, szerződések vagy orvosi leletek nem hagyják el a cég hálózatát.
• Versenyelőny a B2B piacon: egy magyar vagy európai szoftvercég könnyebben tud eladni AI-megoldásokat bankoknak, állami szerveknek vagy egészségügyi intézményeknek, ha garantálni tudja, hogy nincs harmadik fél az adatkezelésben.
• Helyi vagy EU-s szerveren történő futtatás: ha egy cég saját szerveren (vagy európai adatközpontban) futtat egy nyílt paraméteres modellt (pl. Llama, Mistral, Qwen), az ügyféladatok, szerződések vagy orvosi leletek nem hagyják el a cég hálózatát.
• Versenyelőny a B2B piacon: egy magyar vagy európai szoftvercég könnyebben tud eladni AI-megoldásokat bankoknak, állami szerveknek vagy egészségügyi intézményeknek, ha garantálni tudja, hogy nincs harmadik fél az adatkezelésben.
2. Kiszámíthatóbb költségek nagy adatforgalomnál
A token alapú (API) elszámolás induláskor olcsó, de nagy forgalomnál, terhelésnél már drágává válik.
• Fix infrastruktúra-költség: Saját GPU-szerver bérlése vagy vásárlása esetén a költségek fixek, a forgalomtól független.
• Fix infrastruktúra-költség: Saját GPU-szerver bérlése vagy vásárlása esetén a költségek fixek, a forgalomtól független.
• Kisebb, célzott modellek (SLM - Small Language Models): nem minden feladatra kell óriási modell. Egy 7–14 milliárd paraméteres nyílt modell (amely akár egy erősebb szerveren is fut) töredékáron képes elvégezni olyan feladatokat, mint az ügyfélszolgálati e-mailek kategorizálása, számlaadatok kinyerése vagy belső dokumentumkeresés (RAG).
3. Finomhangolás és magyar nyelvi specializáció
A nagy zárt modellek általános tudásban erősek, de egyedi vállalati zsargonban vagy speciális magyar jogi, pénzügyi szövegekben hibáznak.
• Saját tudásbázis beépítése: a nyílt paraméteres modellek súlyai módosíthatóak. Egy cég a saját múltbeli adatain (pl. sikeres ügyfélszolgálati beszélgetéseken vagy magyar jogszabályokon) tovább taníthatja a modellt, amivel egy olyan egyedi „digitális munkatársat” kap, amivel a versenytársai nem rendelkeznek.
• Nincs modell-változás miatti kockázat: a zárt API-k mögötti modelleket a szolgáltatók bármikor frissíthetik, ami elronthatja a cég jól működő promptjait. A saját szerveren futó nyílt modell pontosan ugyanúgy viselkedik ma és két év múlva is.
• Saját tudásbázis beépítése: a nyílt paraméteres modellek súlyai módosíthatóak. Egy cég a saját múltbeli adatain (pl. sikeres ügyfélszolgálati beszélgetéseken vagy magyar jogszabályokon) tovább taníthatja a modellt, amivel egy olyan egyedi „digitális munkatársat” kap, amivel a versenytársai nem rendelkeznek.
• Nincs modell-változás miatti kockázat: a zárt API-k mögötti modelleket a szolgáltatók bármikor frissíthetik, ami elronthatja a cég jól működő promptjait. A saját szerveren futó nyílt modell pontosan ugyanúgy viselkedik ma és két év múlva is.
4. Kockázatkezelés (Vendor Lock-in elkerülése)
• Ha egy európai cég egyetlen amerikai szolgáltatóra építi a termékét, teljesen ki van szolgáltatva a cég áremeléseinek vagy szolgáltatás kimaradásainak.
• A nyílt paraméteres modellek szabványos interfészeken futnak, így ha megjelenik egy jobb nyílt modell, a cég néhány óra alatt lecserélheti a modellt, anélkül, hogy az üzleti folyamatok sérülnének.
• A nyílt paraméteres modellek szabványos interfészeken futnak, így ha megjelenik egy jobb nyílt modell, a cég néhány óra alatt lecserélheti a modellt, anélkül, hogy az üzleti folyamatok sérülnének.
Példák az üzleti hasznosításra
• Könyvelőirodák és pénzügyi cégek: Saját szerveren futó dokumentumelemző rendszer, amely érzékeny pénzügyi adatokat dolgoz fel felhőkapcsolat nélkül.
• Webáruházak és ügyfélszolgálatok: Helyben futtatott, cégre szabott chatbotok, amelyek nem küldik ki a vásárlói adatokat külső cégeknek, és fix havi szerverdíj mellett 0-24-ben működnek.
• Szoftverfejlesztő ügynökségek: Olyan egyedi AI-rendszerek építése és eladása nagyvállalati ügyfeleknek, amelyek teljes egészében az ügyfél saját szerverparkjában működnek.
• Webáruházak és ügyfélszolgálatok: Helyben futtatott, cégre szabott chatbotok, amelyek nem küldik ki a vásárlói adatokat külső cégeknek, és fix havi szerverdíj mellett 0-24-ben működnek.
• Szoftverfejlesztő ügynökségek: Olyan egyedi AI-rendszerek építése és eladása nagyvállalati ügyfeleknek, amelyek teljes egészében az ügyfél saját szerverparkjában működnek.
AI-Integrátorként történő hasznosítása
A modell köré épített, kulcsrakész üzleti megoldást, az adatbiztonságot és a folyamatos üzemeltetést árazza be. A vállalatok többségének (bankoknak, gyártóknak, állami szerveknek, KKV-knak) nincs saját AI-mérnök csapata. Ők nem egy „Llama” vagy „Mistral” modellt akarnak, hanem egy működő rendszert, ami megoldja a problémáikat anélkül, hogy sértené a GDPR-t vagy elszállnának a költségek.
1. „Dobozos”, iparágspecifikus megoldások építése (Vertical AI)
Az integrátor letölti a nyílt paraméteres modellt, összeköti a cég belső rendszereivel (ERP, CRM, dokumentumtár), és egy konkrét iparági problémára szabja.
• Hogyan lesz ebből profitja az integrátornak? Egyszeri fejlesztési/bevezetési díj, plusz havi licencdíj a szoftveres körítésért (felhasználói felület, jogosultságkezelés, munkafolyamatok).
• Példa: a magyar ügyvédi irodáknak vagy könyvelőknek szánt helyi szerveres asszisztens, amely magyar jogszabályokon és az iroda saját iratain keres, és automatikusan szerződés tervezeteket készít.
• Hogyan lesz ebből profitja az integrátornak? Egyszeri fejlesztési/bevezetési díj, plusz havi licencdíj a szoftveres körítésért (felhasználói felület, jogosultságkezelés, munkafolyamatok).
• Példa: a magyar ügyvédi irodáknak vagy könyvelőknek szánt helyi szerveres asszisztens, amely magyar jogszabályokon és az iroda saját iratain keres, és automatikusan szerződés tervezeteket készít.
2. „Szuverén AI” infrastruktúra kiépítése (On-premise / Privát felhő)
Sok európai cég a szigorú adatvédelmi szabályok (GDPR, DORA, NIS2, EU AI Act) miatt nem használhat amerikai felhős AI-t.
• Az integrátor megtervezi és leszállítja a hardvert (vagy beállítja a zárt európai szervert), telepíti a nyílt modellt, optimalizálja a sebességét, és vállalja a rendszer 0–24-es karbantartását (SLA).
• Integrátori bevételi forrás: a hardver-viszonteladói árrés, rendszerintegrációs munkadíj és magas, kiszámítható havi üzemeltetési (karbantartási) díj.
• Az integrátor megtervezi és leszállítja a hardvert (vagy beállítja a zárt európai szervert), telepíti a nyílt modellt, optimalizálja a sebességét, és vállalja a rendszer 0–24-es karbantartását (SLA).
• Integrátori bevételi forrás: a hardver-viszonteladói árrés, rendszerintegrációs munkadíj és magas, kiszámítható havi üzemeltetési (karbantartási) díj.
3. Saját adatokon való finomhangolás (Fine-tuning) és RAG-rendszerek
A nyílt modell még nem tudhatja a megrendelő cég belső folyamatait, termékeit és szakszavait, ami a folyamatszervező integrártor feladata:
• Az integrátor elvégzi az adatok tisztítását, felépíti a vállalati tudásbázist (RAG – Retrieval-Augmented Generation), és a megrendelő saját adatain tanítja tovább (fine-tune) a nyílt paraméteres modellt.
• A vevő olyan megoldásokat kap a saját szakterületén (pl. gyártási hibaelhárítás, speciális ügyfélszolgálat), amire az általános célú zárt modellek nem képesek, és a tudás a cég saját tulajdonában marad.
• Az integrátor elvégzi az adatok tisztítását, felépíti a vállalati tudásbázist (RAG – Retrieval-Augmented Generation), és a megrendelő saját adatain tanítja tovább (fine-tune) a nyílt paraméteres modellt.
• A vevő olyan megoldásokat kap a saját szakterületén (pl. gyártási hibaelhárítás, speciális ügyfélszolgálat), amire az általános célú zárt modellek nem képesek, és a tudás a cég saját tulajdonában marad.
4. Költségoptimalizálási tanácsadás (a zárt modell kiváltása)
Sok cég elindult az OpenAI vagy Anthropic API-ján, de ahogy nő a forgalom, a havi token-számlák elszállnak.
• Az integrátor átvilágítja a cég folyamatait, és a drága, nagy zárt modelleket lecseréli kisebb, célzott nyílt paraméteres modellekre (pl. 8B vagy 32B paraméteres verziókra), amelyek saját szerveren futnak.
• Üzleti modell: sikerdíj vagy projektalapú integrátor díjazás a megtakarított API-költségek arányában.
• Az integrátor átvilágítja a cég folyamatait, és a drága, nagy zárt modelleket lecseréli kisebb, célzott nyílt paraméteres modellekre (pl. 8B vagy 32B paraméteres verziókra), amelyek saját szerveren futnak.
• Üzleti modell: sikerdíj vagy projektalapú integrátor díjazás a megtakarított API-költségek arányában.
5. Jogi és biztonsági „védőpajzs” (Guardrails & Compliance)
A nyílt modellek „nyersen” néha hallucinálnak, vagy nem megfelelő választ adnak, ami egy banknál vagy biztosítónál valódi, komoly kockázat. Az integrátor beépíti a szűrőrendszereket (guardrails), a naplózást, a jogosultsági szinteket és az EU AI Act-nek való megfelelést biztosító dokumentációt és monitorozást.
Integrátori profit: tehát amíg a modell készítője 0 forintot keres a súlyokon, az integrátor a szolgáltatáson, a biztonságon és a testreszabáson keres. A megrendelő azért fizet, mert egy kiszámítható havi díjú, jogilag tiszta, saját tulajdonú rendszert kap, nem pedig egy külső amerikai tech cég API-jától való függőséget.
*A rendszergazda csak üzemeltetője a csapatnak. Míg a rendszergazda (vagy modern nevén DevOps / MLOps mérnök) azért felel, hogy a szerver, GPU és a szoftver stabilan és biztonságosan fusson, addig az AI-integrátor egy cég vagy szakember, aki üzleti megoldást épít az ügyfél meglévő folyamatai köré, rendszerszervező, és kezeli, fizeti az API-t (az integrátor beépíti Az API költségét a saját havidíjába, licencdíjába, vagy a projekt árába, gyakran némi árréssel).
(A képek forrása: internetes képgyűjtemények.)